Własne AI
na własnych GPU.
Stawiamy serwer z kartami NVIDIA Blackwell, uruchamiamy na nim otwarte modele i wystawiamy je jednym API dla Twoich aplikacji i agentów. Zapytania, dokumenty i odpowiedzi nie opuszczają Twojej sieci.
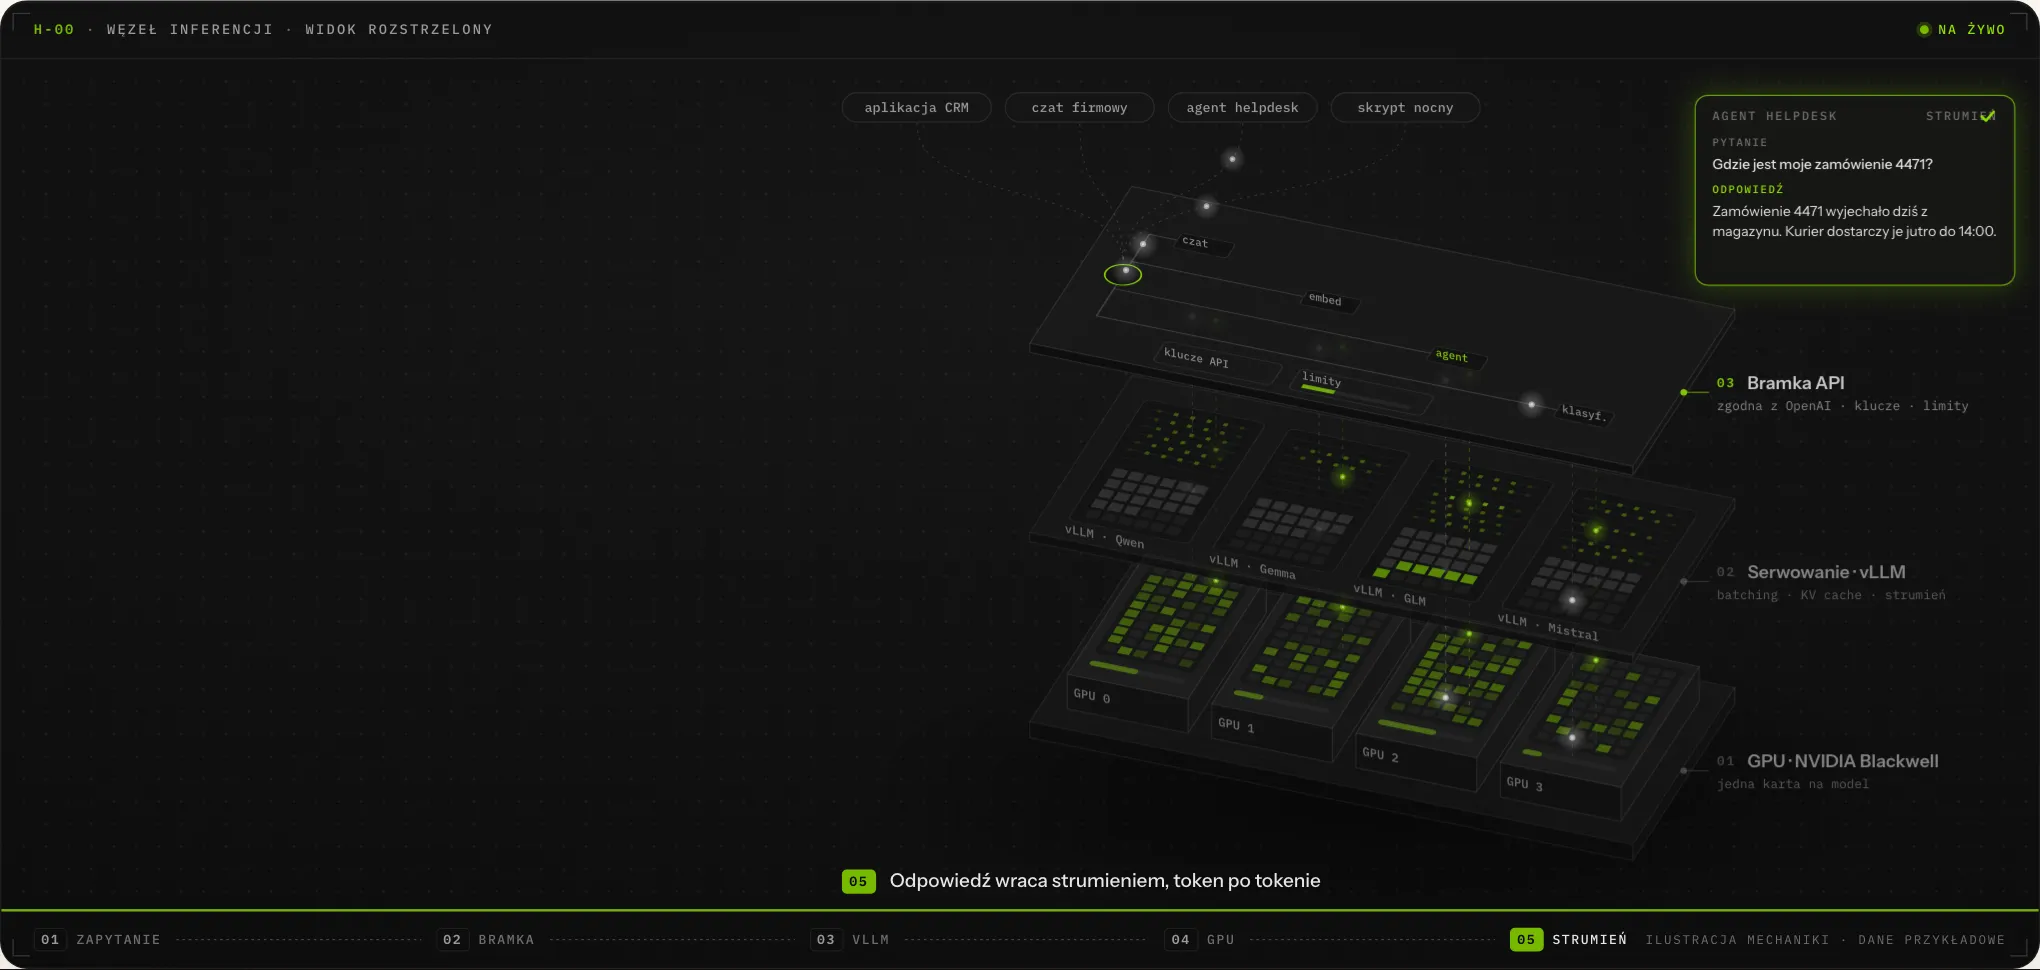
Węzeł GPU, który stoi u Ciebie
Jeden serwer, kilka kart NVIDIA Blackwell, szybkie dyski na wagi modeli i karta sieciowa w sieci wewnętrznej. Każda karta dostaje swoje zadanie: jedna prowadzi rozmowy, druga liczy embeddingi, trzecia obsługuje agenta. Obciążenie każdej widać na bieżąco, w procentach.

Jak model odpowiada wielu naraz
vLLM nie obsługuje zapytań po kolei. W każdym kroku liczy po jednym tokenie dla wszystkich rozmów w batchu, a nowe zapytanie wskakuje w miejsce, które właśnie się zwolniło. Odpowiedź płynie token po tokenie, więc tekst pojawia się od razu, a nie po całej odpowiedzi.

Wspólny kontekst liczony raz
Instrukcja systemowa, regulamin, opis narzędzi agenta: ten sam początek trafia do setek zapytań. Model trzyma policzone tokeny w KV cache, a prefix caching pozwala kolejnym zapytaniom wziąć gotowe bloki. Od nowa liczy się tylko to, co nowe: samo pytanie.

Wiele modeli, jedna bramka
Każdy model działa na swojej karcie, a aplikacje widzą jeden adres zgodny z API OpenAI. Bramka sprawdza klucz, pilnuje limitów i po polu „model” kieruje zapytanie na właściwą kartę. Wymiana modelu pod spodem nie wymaga zmian w aplikacji.

Wdrożenie jednym poleceniem
Serwery, sieć i reguły zapory opisujemy w Terraformie, kontenery vLLM i ich konfigurację w Ansible. Na co dzień używamy naszego narzędzia inferctl: wybierasz profil modelu, flagi vLLM i kartę, a playbook robi resztę, aż do zielonego health checka.

Widzisz wszystko
Tokeny na sekundę dla każdego modelu, długość kolejki, zajętość KV cache, temperatury i obciążenie kart. Kiedy rośnie ruch, widać, jak batch się zapełnia, a kolejka rośnie i znika. Alert przychodzi, zanim ktoś zdąży zgłosić problem.

Twoje dane zostają u Ciebie
Modele, bramka i baza wiedzy działają w sieci wewnętrznej. Zapytania, dokumenty i odpowiedzi krążą tylko między Twoimi serwerami, a ruch wychodzący do chmury blokuje zapora. Wagi modeli leżą na Twoim dysku.

Nasz szacunek dla 2026 roku. Ten sam stos, który widać wyżej: karty NVIDIA Blackwell, vLLM, jedna bramka API i wdrożenia z kodu. To z niego budujemy rozwiązania dla klientów.
Twoje modele.
Twój sprzęt. Twoje dane.
Opowiedz, co model ma robić i gdzie mają zostać dane. Pokażemy demo na naszych GPU i zaproponujemy sprzęt dopasowany do Twojego ruchu.
dane w scenach są przykładowe